数组在函数内
- 在函数内定义数组时,如果无其他声明,该数组即为局部变量,拥有局部变量的所有特性。数组中的数据存储在内存中是线性连续的,数据排列顺序由低地址到高地址,数组名称表示该数组的首地址
- 学到了数组,就不得不提一下字符串。在C++中,字符串本身就是数组,根据约定,该数组的最后一个数据统一使用0作为字符串结束符。在编译器下,为字符类型的数组赋值(初始化)其实是复制字符串的过程。这里并不是单字节复制,而是每次复制一个寄存器大小的数据。两个内存间的数据传递需要借用寄存器,而每个寄存器一次可以保存4或者8字节的数据,如果以单字节的方式复制就会浪费3或者7字节的空间,而且多次数据传递也会降低执行效率,所以编译器采用4或者8个字节的复制方式
数组作为参数
- 数组中的数据元素是连续存储的,并且数组是同类型数据的集合。当作为参数传递时,数组所占内存通常大于4字节,那么它是如何将数据传递到目标函数中并使用的呢?
- 当数组作为参数时,数组的下标值被省略了。这是因为当数组作为函数形参时,函数参数中保存的是数组的首地址,这是一个指针变量。
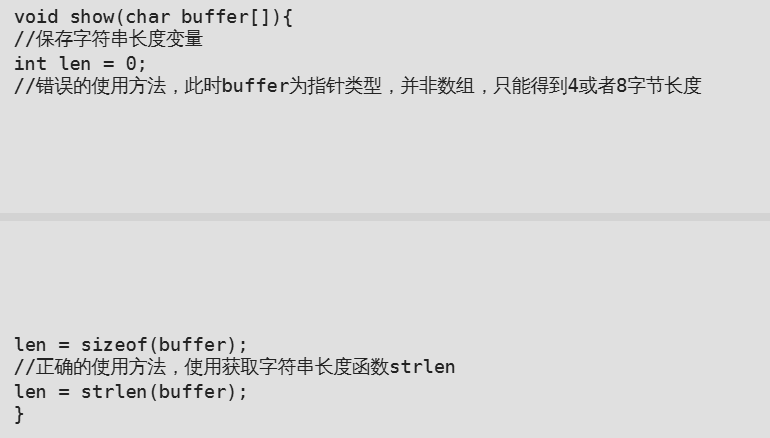
- 虽然参数是指针变量,但需要特别注意的是,实参数组名为常量值,而指针或形参数组为变量。使用sizeof(数组名)可以获取数组的大小,而对指针或者形参中保存的数组名使用sizeof只能得到当前平台的指针长度。在32位程序中,指针的长度为4字节,64位程序中指针的长度为8字节。
- 字符串处理函数在Debug版下非常容易识别,而在Release版下,它们会被作为内联函数进行编译处理,因此没有了函数调用指令call。但是,我们只须认真分析一下,总结出内联库函数的特点和识别要领即可。本节将以字符串复制函数strcpy作为示例进行讲解。
- 优化后的strlen()函数被编译为内联函数,使用循环取代函数调用。至此,对求字符串长度函数strlen()的分析就完成了,有了它作基础,就可以继续分析字符串复制函数strcpy()
- 在字符串初始化时,利用xmm寄存器初始化数组的值,因为xmm是一个16个字节的寄存器,所以一次可以初始化16个字节的值,这样效率更高。最后使用循环拷贝字符串,直到复制到’\0’为止。
数组作为返回值
- 数组作为函数的返回值与作为函数的参数编译器的处理方式大同小异,都是将数组的首地址以指针的形式进行传递,但是它们也有不同之处。当数组作为参数时,其定义所在的作用域必然在函数调用以外,在调用之前就已经存在。所以,在函数中对数组进行操作是没有问题的,而数组作为函数返回值则存在着一定的风险。
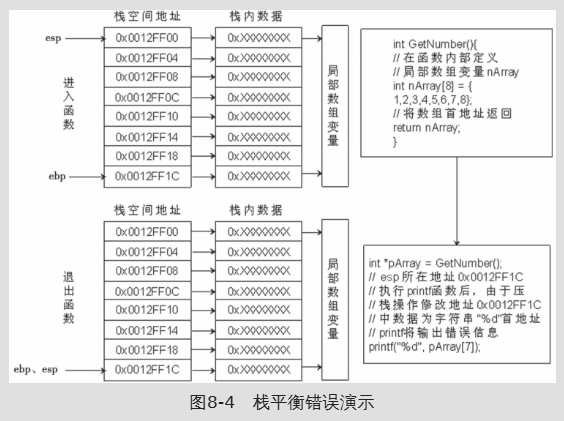
- 当数组为局部变量数据时,便产生了稳定性问题。在退出函数时需要平衡栈,而数组是作为局部变量存在的,其内存空间在当前函数的栈内。如果此时函数退出,栈中定义的数据将变得不稳定。由于函数退出后栈顶寄存器会回归到调用前的位置上,而函数内的局部数组在栈顶寄存器之下,所以数据随时都可能被其他函数调用过程产生的栈操作指令破坏。数据的破坏将导致函数返回结果的不确定性,影响程序的结果
- 如果既想使用数组作为返回值,又要避免图8-4中的错误,可以使用全局数组、静态数组或上层调用函数中定义的局部数组。全局数组与静态数组都属于变量,它们的特征与全局变量、静态变量相同,看上去就是连续定义的多个同类型的变量
- 静态数组在全局情况下和全局数组相同。作为局部作用域定义时,则同样会检查相应的标志位,并对局部静态数组元素赋值。与局部静态变量有些不同,无论局部静态数组有多少个元素,也只会检查一次初始化标志位
下标寻址和指针寻址
- 访问数组的方法有两种:通过下标访问(寻址)和通过指针访问(寻址)。通过下标访问的方式更为简便,因此比较常用,其格式为“数组名[标号]”。指针寻址的方式不但没有下标寻址便利,而且效率也比下标寻址低。因为指针是存放地址数据的变量类型,所以在数据访问的过程中需要先取出指针变量中的数据,然后针对此数据进行地址偏移计算,从而寻址到目标数据。数组名本身就是常量地址,可直接针对数组名代替的地址值进行偏移计算。
- 使用了指针寻址和下标寻址两种方式访问字符数组buffer。从这两种访问方式的代码实现来看,指针寻址方式要经过2次寻址才能得到目标数据,而下标寻址方式只需要1次。指针寻址比下标寻址多了一次寻址操作,效率自然要低。 虽然使用指针寻址方式需要经过2次间接访问,效率较低,但其灵活性更强,可通过修改指针中保存的地址数据,访问其他内存中的数据,而数组下标在没有越界使用的情况下只能访问数组内的数据。
- 在进行下标方式寻址时,如何准确找到数组中数据的地址呢?由于数组内的数据是连续排列的,而且数据类型一致,所以只需要数组首地址、数组元素的类型和下标值,就可以求出数组某下标元素的地址。假设首地址为aryAddr,数组元素的类型为type,元素个数为M,下标为n,求数组中某下标元素的地址,则寻址公式如下。
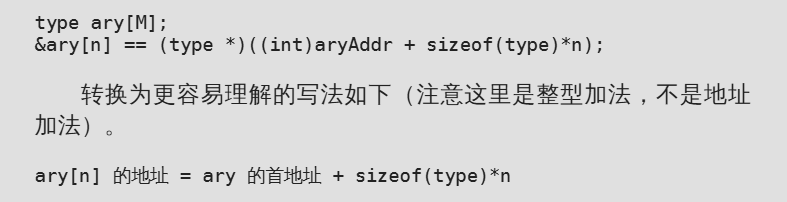
下标值为整型常量的寻址
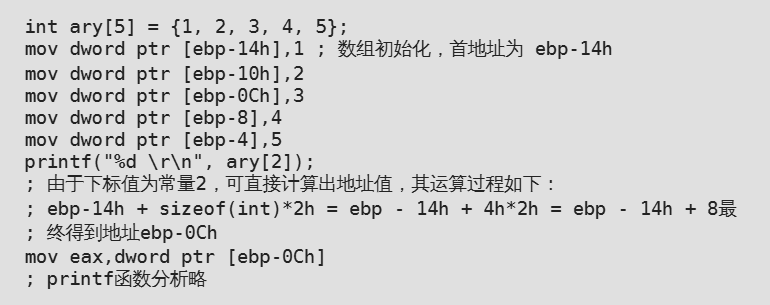
- 在下标值为常量的情况下,由于类型大小为已知数,编译器可以直接计算得出数据所在的地址。其寻址过程和局部变量相同
下标值为整型变量的寻址
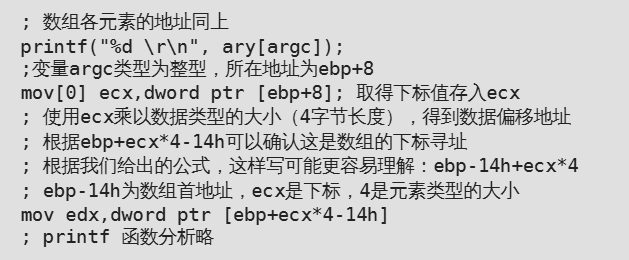
- 当下标值为变量时,编译器无法算出对应的地址,只能先进行地址偏移计算,再得出目标数据所在的地址。
下标值为整型表达式的寻址
下标值为表达式时,会先算出表达式的结果,然后将其作为下标值。如果表达式为常量计算,则编译过程中执行常量折叠,编译时提前计算出结果,其结果依然是常量,最后还是以常量作为下标,藉此寻址数组内元素。以表达式ary[2*2]为例,编译过程中计算2×2得到4,将4作为整型常量下标值进行寻址,其结果等价于ary[4]。
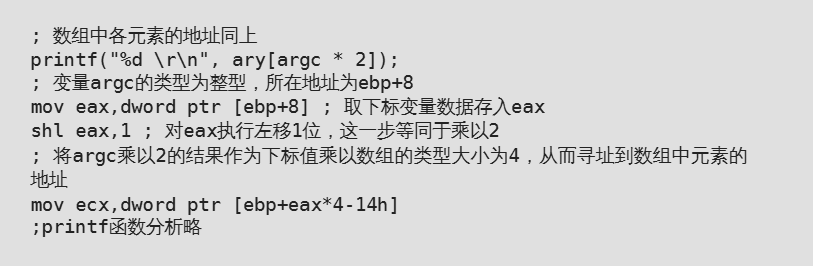
数组下标寻址使用的方案和指针寻址公式非常相似,都是利用首地址加偏移量。数组的3种下标寻址方案同样也可以应用在指针寻址中。
在编译器中,不会对数组的下标进行访问检查,使用数组时很容易出现越界访问的错误。当下标值小于0或大于数组下标最大值时,会访问到数组邻近定义的数据,造成越界访问,进而导致程序崩溃,或者产生更为严重的后果
下标寻址方式也可以被指针寻址方式代替,但指针寻址方式需要经过两次间接访问,第一次是访问指针变量,第二次才能访问到数组元素,故指针寻址的执行效率不会高于下标寻址,但是在使用的过程中会更加方便。
数组下标和指针寻址如此相似,如何在反汇编代码中区分它们呢?只要抓住一点即可,那就是指针寻址需要两次以上间接访问才可以得到数据。因此,在出现了两次间接访问的反汇编代码中,如果第一次间接访问得到的值作为地址,则必然存在指针。图8-6中使用寄存器作为指针变量,保存全局数组的地址,从而利用保存了全局数组首地址寄存器对该数组进行间接访问操作。
数组下标寻址的识别相对复杂,下标为常量时,由于数组的元素长度固定,sizeof(type)*n也为常量,产生了常量折叠,编译前可直接算出偏移量,因此只须使用数组首地址作为基址加偏移即可寻址相关数据,不会出现二次寻址的情况。当下标为变量或者变量表达式时,会明显体现出数组的寻址公式,且发生两次内存访问,但是和指针寻址明显不同,第一次访问的是下标,这个值一般不会作为地址使用,且代入公式计算后才得到地址。值得注意的是,在打开优化02选项后,须留心各种优化方式。
多维数组
- 前几节介绍了一维数组的各种展示形态,而超过一维的多维数组在内存中如何存储呢?内存中数据是线性排列的。多维数组看上去是在内存使用了多块空间存储数据,事实真是如此吗?实际上,编译器采用了非常简单有效的方法,将多维数组通过转化重新变为一维数组。本节对多维数组的讲解将以二维数组为例,如二维整型数组:int nArray[2][2],经过转换后可用一维数组表示为int nArray[4]。它们在内存中的存储方式相同,如图8-9所示。
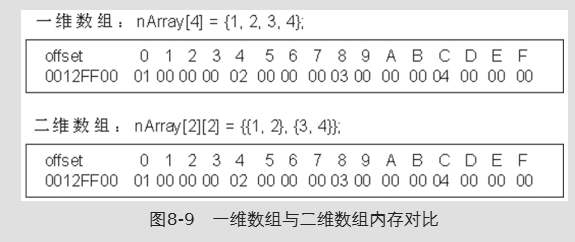
- 两者在内存中的排列顺序相同,可见在内存中根本没有多维数组。二维数组甚至多维数组的出现只是为了方便开发者计算偏移地址、寻址数组数据。
- 计算二维数组的大小非常简单,一维数组使用类型大小乘以下标值,得到一维数组占用内存大小。二维数组中的二维下标值为一维数组的个数,因此只要将二维数组的下标值乘以一维数组占用内存大小,即可得知二维数组的大小。
- 求得二维数组的大小后,如何计算地址偏移呢?根据之前的学习,我们知道一维数组的寻址公式为数组首地址+类型大小*下标值。计算二维数组的地址偏移要先分析二维数组的组成部分,如整型二维数组int nArray[2][3]可拆分为如下三个部分。
- 数组首地址:nArray。
- 一维元素类型:int[3],此下标值记作j。
- 类型:int。
- 元素个数:[3]。
- 一维元素个数:[2],此下标值记作i。
- 上述二维数组的组成可理解为两个一维整型数组的集合,而这两个一维数组又各自拥有3个整型数据。在地址偏移的计算过程中,先计算首地址到一维数组间的偏移量,利用数组首地址加上偏移量,得到某个一维数组所在地址。以此地址为基地址,加上一维数组中数据地址偏移,寻址到二维数组中的某个数据。寻址公式如下。

- 二维以上数组的寻址同理,多维数组的组成可看作一个包裹套小包裹。如三维数组int nArray[2][3][4],最左侧的int nArray[2]为第一层包内数据,下标值2说明在第一层包裹中有两个二维数组int[3][4]小包裹。打开其中一个小包裹,里面包着一个一维数组int[4]。打开另一个小包裹,里面包含一个int类型的数据。依照这个拆包过程,结合公式,就可以准确定位多维数组的数据。
- 二维数组的寻址过程比一维数组多一步操作,先取得二维数组中某个一维数组的首地址,再利用此地址作为基址寻址到一维数组中某个数据的地址处。
- 两个下标值都是未知变量,若其中某一个下标值为常量,则不会出现二次寻址计算。二维数 组寻址转换成汇编后的代码和一维数组相似。因为下标值为常量,且类型大小可预先计算,所以变成两个常量之间的计算,编译器可能会利用常量折叠直接计算出偏移地址。
- 使用02选项进行优化后,数组中的各成员不会连续初始化,而是将一维数组与二维数组同步初始化,因为它们中的数据都是1、2、3、4,所以可以使用公共表达式进行优化。
存放指针类型数据的数组
- 顾名思义,存放指针类型数据的数组中,各数据元素都是由相同类型的指针。指针数组的语法如下。
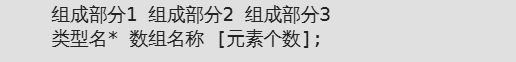
- 指针数组主要用于管理同种类型的指针,一般用于处理若干个字符串(如二维字符数组)。使用指针数组处理多字符串数据更加方便、简洁、高效。
- 知道了如何识别数组后,识别指针数组就会相对简单。既然都是数组,必然遵循数组具备的相关特性。但是指针数组中的数据为地址类型,需要再次进行间接访问获取数据。
- 数组由3个指针变量组成,故32位程序长度为12字节;64位程序长度为24字节。
- 该数组指向的字符串长度和数组本身没有关系,而二维字符数组则与之不同。
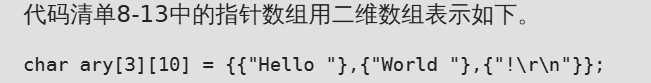
- 同样存储了3个字符串,指针数组中存储的是各字符串的首地址,而二维字符数组中存储的是每个字符串的字符数据。这是它们之间本质的不同。要对它们进行区分也非常简单,分析它们的初始化过程即可。
- 在二维字符数组初始化的过程中,赋值的不是字符串地址,而是字符数据,据此可以明显地将二维字符数组与字符指针数组区分开。如果代码中没有初始化操作,就需要分析如何寻址数据。
- 虽然二维字符数组和指针数组的寻址过程非常相似,但依然有一些不同。字符指针数组寻址后,得到的是数组成员内容,而二维字符数组寻址后得到的是数组中某个一维数组的首地址。
指向数组的指针变量
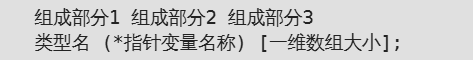
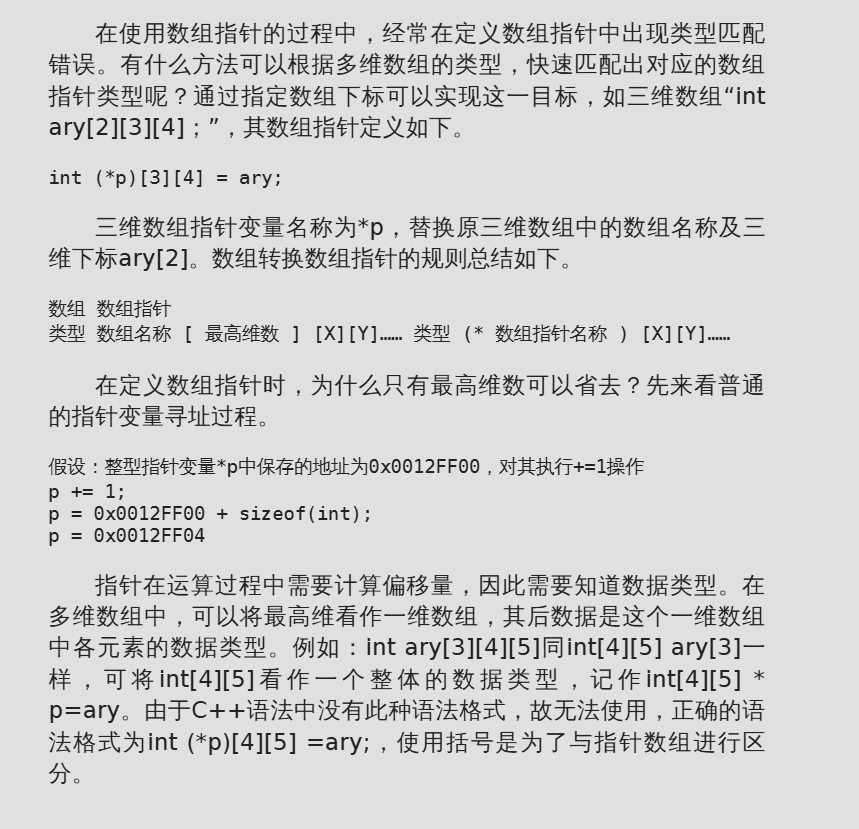
- 什么是指向数组的指针呢?在学习一维数组时,我们已经有所接触。当指针变量保存的数据为数组的首地址,且将此地址解释为数组时,该指针变量被称为数组指针。指向数组元素的指针很简单,只要是指针变量,都可以用于寻址该类型一维数组的各元素,得到数组中的数据。而指向一维数组的数组指针会有些变化,指向一维数组的数组指针定义格式如下。
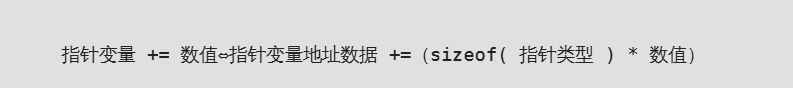
- 对指向二维数组的数组指针执行取内容操作后,得到的还是一个地址值,再次执行取内容操作才能寻址到二维字符数组中的单个字符数据。这个过程看上去与二级指针相似,实际上并不一样。二级指针是指针类型,其偏移长度在32位下固定为4字节,而数组指针的类型为数组,其偏移长度随数组而定,两者的偏移计算不同,不可混为一谈。
函数指针
- 通过call指令跳转到函数首地址处,执行函数内的指令代码。既然是地址,当然可以使用指针变量存储,用于保存函数首地址的指针变量被称为函数指针。
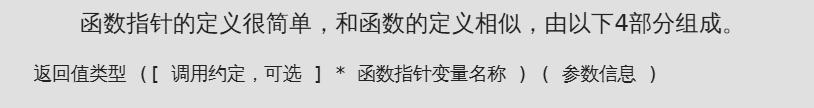
- 函数指针的类型由返回值、参数信息、调用约定组成,它们决定了函数指针在函数调用过程中参数的传递、返回值信息以及如何平衡栈顶。在没有特殊说明的情况下,调用约定与C++编译器中的设置相同。
- 与函数调用的最大区别在于函数是直接调用的,而函数指针需要取出指针变量中保存的地址数据,间接调用函数。
- 函数指针是比较特殊的指针类型,因为其保存的地址数据为代码段内的地址信息,而非数据区,所以不存在地址偏移的情况。指针的操作非常灵活,为了防止函数指针发生错误的地址偏移,C++编译器在编译期间对其进行检查,不允许对函数指针类型变量执行加法和减法等没有意义的运算。
关于本文
由 GuQing 撰写,采用 CC BY-NC 4.0 许可协议。