- 在C++中,结构体和类都具有构造函数、析构函数和成员函数,两者只有一个区别:结构体的访问控制默认为public,而类的默认访问控制是private。对于C++中的结构体而言,public、private、protected的访问控制都是在编译期进行检查,当越权访问时,编译过程中会检查此类错误并给予提示。编译成功后,程序在执行过程中不会在访问控制方面做任何检查和限制。因此,在反汇编中,C++的结构体与类没有分别,两者的原理相同,只是类型名称不同,本章使用的示例多为类。
对象的内存布局
- 结构体和类都是抽象的,在真实世界中它们只可以表示某个群体,无法确定这个群体中的某个独立个体,而对象则是群体中独立存在的个体。例如,地球上最智慧的生物是人,人便是抽象事物,可以看作是一个类。“人”只能描述这个类型的事物具有哪些特征,无法得知具体是哪一个人。在“人”这个类中,如关羽、张飞等都是独立存在的实体,可被看作“人”这个类中的实体对象。
- 人 → 类、结构,抽象的概念
- 关羽 → 实例对象,实际存在的事物
- 由于类是抽象概念,当两个类的特征相同时,它们之间就是相等的关系。而对象是实际存在的,即使它们之间包含的数据相同,也不能视为同一个对象。下面我们通过一个简单的示例(见代码清单9-1)来加深理解类与对象之间的关系。
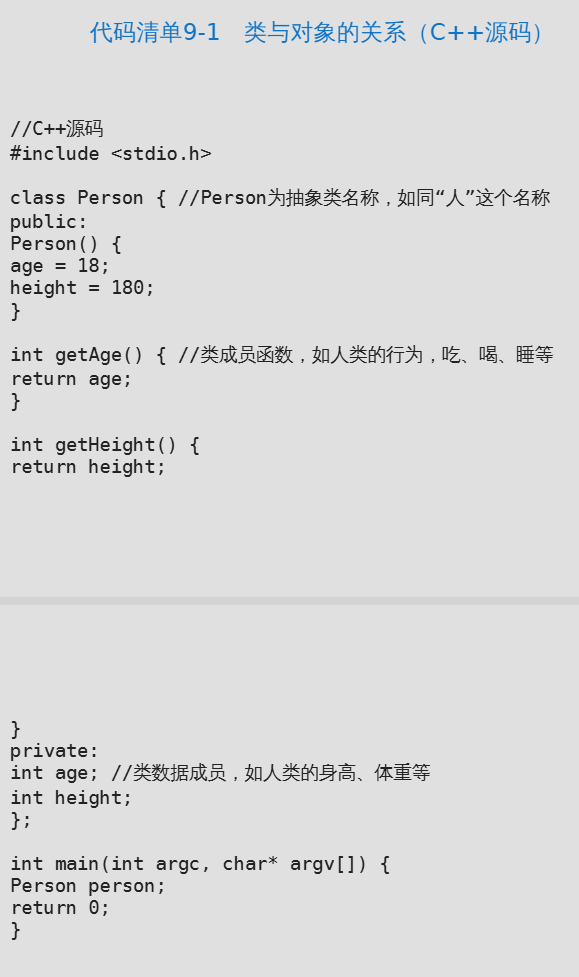
- 代码清单9-1中定义了自定义类型Person类以及该类的实例对象person。Person与C++中的int都属于数据类型。整型变量的数据大小为4字节,使用class关键字的自定义类型如何分配各数据成员呢?我们下面调试运行代码清单9-1,分析对象person的各成员在内存中的布局,如图9-1所示。
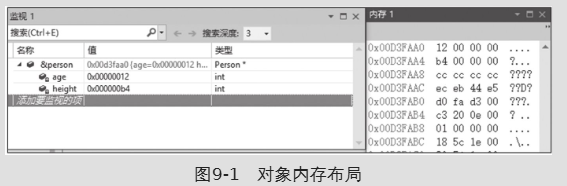
- 对象person在内存中的地址为0x00D3FAA0,该地址 处 定 义 了 对 象 person 的 各 个 数 据 成 员 , 分 别 存 放 在 地 址0x00D3FAA0与0x00D3FAA4处。对象person中先定义的数据成员在低地址处,后定义的数据成员在高地址处,依次排列。对象的大小只包含数据成员,类成员函数属于执行代码,不属于类对象的数据。
- 根据图9-1可知,凡是属于Person类型的变量,在内存中都会占据8字节的空间。这8字节由类中的两个数据成员组成,它们都是int类型,数据长度为4字节。从内存布局上看,类与数组非常相似,都是由多个数据元素构成的,但类的能力要远远大于数组。类成员的数据类 型定义非常广泛,除本身的对象外,任何已知的数据类型都可以在类中定义。
- 为什么在类中不能定义自身的对象呢?这是因为类需要在申请内存的过程中计算出自身的大小,以用于实例化。如果在类中定义了自身的对象,在计算各数据成员的长度时,又会回到自身,这样就形成了递归定义,而这个递归并没有出口,是一个无限循环的递归定义,所以不能定义自身对象作为类成员。但是,自身类型的指针除外,因为任何类型的指针在32位下占用的内存大小始终为4字节,64位下占8个字节,等同于一个常量值,因此将其作为类的数据成员不会影响长度的计算。根据以上知识,可以总结出如下对象长度计算公式。

- 这个公式是否正确呢?
- 从表面上看,这个公式没有问题,但对象的大小计算远没有这么简单。即使类中没有
- 继承和虚函数的定义,仍有三种特殊情况能推翻此公式:空类、内存对齐、静态数据成员。当出现这三种情况时,使用此公式得到的对象长度与实际情况不符。下面我们详细介绍一下为何该公式不适用这三种情况。
空类
- 空类中没有任何数据成员,按照该公式计算得出的对象长度为0字节。类型长度为0,则此类的对象不占内存空间。而实际情况是,空类的长度为1字节。如果对象完全不占用内存空间,空类就无法取得实例对象的地址,this指针失效,因此不能被实例化。而类的定义是由成员数据和成员函数组成的,在没有成员数据的情况下,还可以有成员函数,因此仍然需要做实例化。分配1字节的空间用于类的实例化,这1字节的数据并没有被使用。
内存对齐
- 在C++中,类和结构体中的数据成员是根据它们出现的顺序,依次申请内存空间的。由于内存对齐的原因,它们并不一定会像数组那样连续地排列;由于数据类型不同,占用的内存空间大小也会不同,在申请内存时,会遵守一定的规则。
- 在为结构体和类中的数据成员分配内存时,结构体中当前数据成员 类 型 的 长 度 为 M , 指 定 的 对 齐 值 为 N , 那 么 实 际 对 齐 值 为 q = min(M, N),成员的地址安排在q的倍数上,代码如下所示。
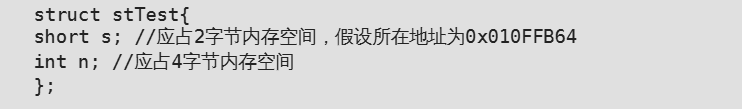
- 数据成员s的地址为0x010FFB64,类型为short,占2字节内存空间。C++中通常指定的对齐值默认为8,short的长度为2,实际对齐值取两者较小者,即2。因此short被分配在地址0x010FFB64处(此地址是2的倍数,可分配)。接下来,轮到为第二个数据成员分配内存了,如果分配在s后,第二个数据成员应在地址0x010FFB66处,但第二个数据成员为int类型,占4字节内存空间,与指定的对齐值进行比较后,实际对齐值取int类型的长度4,而地址0x010FFB66不是4的倍数,需要插入两个字节填充,以满足对齐条件,因此第二个数据成员被定义在地址0x010FFB68处,如图9-2所示。
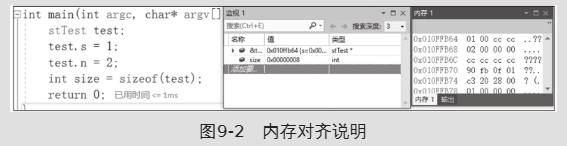
- 内存监视窗口显示了test对象所在地址中的数据。在short类型变量占用的地址0x010FFB66处,数据成员s被赋值为1。 在其后插入了两个0xCC数据,它们便是编译器用于对齐而插入的,实际运行中并没有使用这两个字节中的数据。
- 上述示例讲到了结构体成员对齐值的问题,接下来我们讨论对齐值对结构体整体大小的影响。如果按照C++默认的8字节对齐,那么结构体的整体大小要能被8整除,代码如下所示。
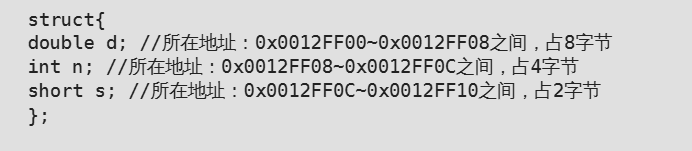
- 上例中结构体成员的总长度为8+4+2=14,按默认的对齐值设置要求,结构体的整体大小要能被8整除,于是编译器在最后一个成员s所占内存之后加入2字节空间填补到整个结构体中,使总大小变为8+4+2+2=16,这样就满足了对齐的要求。
- 但是,并非设定了默认对齐值就能将结构体的对齐值锁定。如果结构体中的数据成员类型最大值为M,指定的对齐值为N,那么实际对齐值就是min(M, N),代码如下所示。
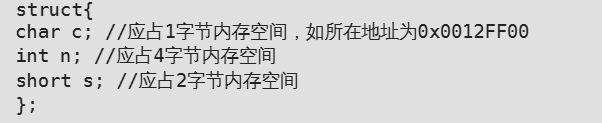
- 以上结构如果还是按照8字节的方式对齐,布局格式如下所示。
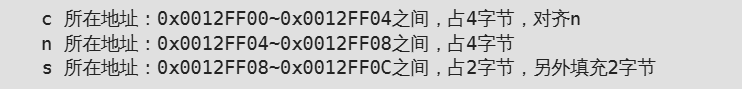
- 随后定义的数据成员s应该使用6字节的空数据对齐。编译器通过检查发现,结构中最大的类型为n数据,占4字节空间。于是将对齐值 由8调整为4,重新调整后,s只需要填充2字节的空白数据就可以实现对齐了。
- 既 然 有 默 认 的 对 齐 值 , 就 可 以 在 定 义 结 构 体 时 进 行 调 整 , 在C++中可使用预编译指令#pragma pack(N)调整对齐大小。修改以上示例,调整对齐值为1,代码如下所示。
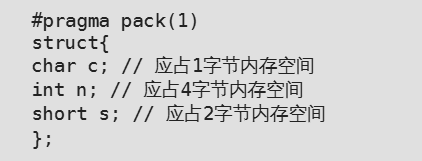
- 调整对齐值后,根据对齐规则,在分配n时无须插入空白数据。对齐值为1,n占4字节大小,很明显,使用pack设定的对齐值更小,因此采用对齐值1的倍数计算分配内存空间的首地址,n紧靠在c之后即可,这样c只占用1字节内存空间。因为设定的对齐值小于、等于结构体中所有数据成员的类型长度,所以结构总长度只要是1的倍数即可。在这个例子中,结构总长度为7。
- 使用pack修改对齐值也并非一定会生效,与默认对齐值一样,都需要参考结构体中的数据成员类型。当设定的对齐值大于结构体中的数据成员类型时,此对齐值同样是无效的。对齐值的计算流程就是将设定的对齐值与结构体中最大的基本类型数据成员的长度进行比较,取两者之间的较小者。
- 当结构体中以数组作为成员时,计算对齐值是根据数组元素的长度,而不是数组的整体大小,代码如下所示。
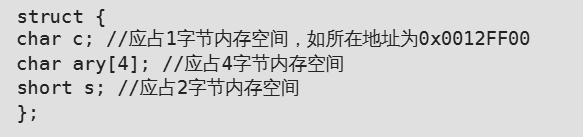
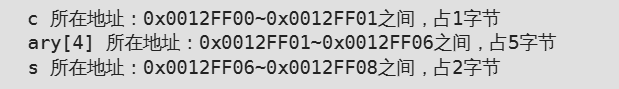
- 按照对齐规定,c与ary的对齐没有缝隙,无须插入空白数据,当ary与s进行对齐时,c与ary在内存中将会占5字节,此时按照结构中当前的数据类型short进行对齐,插入1字节的数据,结构布局如下所示。
- 根据结构体中的各数据成员类型可知,最大类型的数据成员s占2字节,其余成员类型各为1字节。在默认的编译选项下,对齐值为8,而s长度为2,因此会按照short类型的长度(2字节)进行对齐,此时结构的大小为8字节,无须填入字节即可满足要求。当结构体中出现结构体类型的数据成员时,不会将嵌套的结构体类型的整体长度加入对齐值计算中,而是以嵌套定义的结构体使用的对齐值进行对齐,代码如下所示。
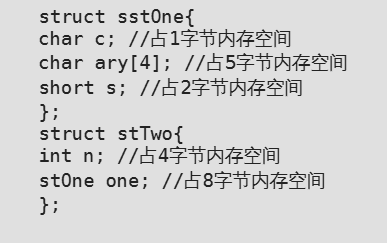
- 在以上结构中,虽然stOne结构占8字节,但由于其对齐值为2,因此stTwo结构体中的最大类型便是int,以4作为对齐值。所以,结构stTwo的总大小并非以8字节对齐的16字节,而是以4字节对齐的12字节。
- 因为存在内存对齐,数据的布局变化多端,所以在分析结构体和类的数据成员布局时,不能单纯地参考各数据成员的类型长度,按顺序进行排列,而应该按上述方法仔细观察和分析。另外,各编译器的实现效果可能有所不同,应详细阅读相关文档。
静态数据成员
- 当类中的数据成员被修饰为静态时,对象的长度计算又会发生变化。虽然静态数据成员是在类中被定义的,但它与局部静态变量类似,存放的位置和全局变量一致。只是编译器增加了作用域的检查,在作用域之外不可见。同类对象将共同享有静态数据成员的空间
- 通过以上讲解我们发现,对象的内存布局并不简单。在类中定义了虚函数和类为派生类等情况下,对象的内存布局中将含有虚函数表和父类数据成员等信息,这将使长度计算变得更为复杂。我们要从简单的情况入手,先掌握最基本的类对象的内存结构分析方法,再深入学习。
- 当对象为全局对象时,其内存布局与局部对象相同,只是所在内存地址以及构造函数和析构函数的触发时机不同。全局对象所在的内存地址空间为全局数据区,而局部对象的内存地址空间在栈中。第10章将详细讲解全局对象构造函数初始化以及析构函数释放的全过程。
- 了解了类中数据成员的内存布局后,如何访问它们呢?在类方法中,又是如何知道数据成员在内存中的地址以及其中的数据信息呢?带着这些疑问,我们进入9.2节的学习,了解神秘的this指针。
this指针
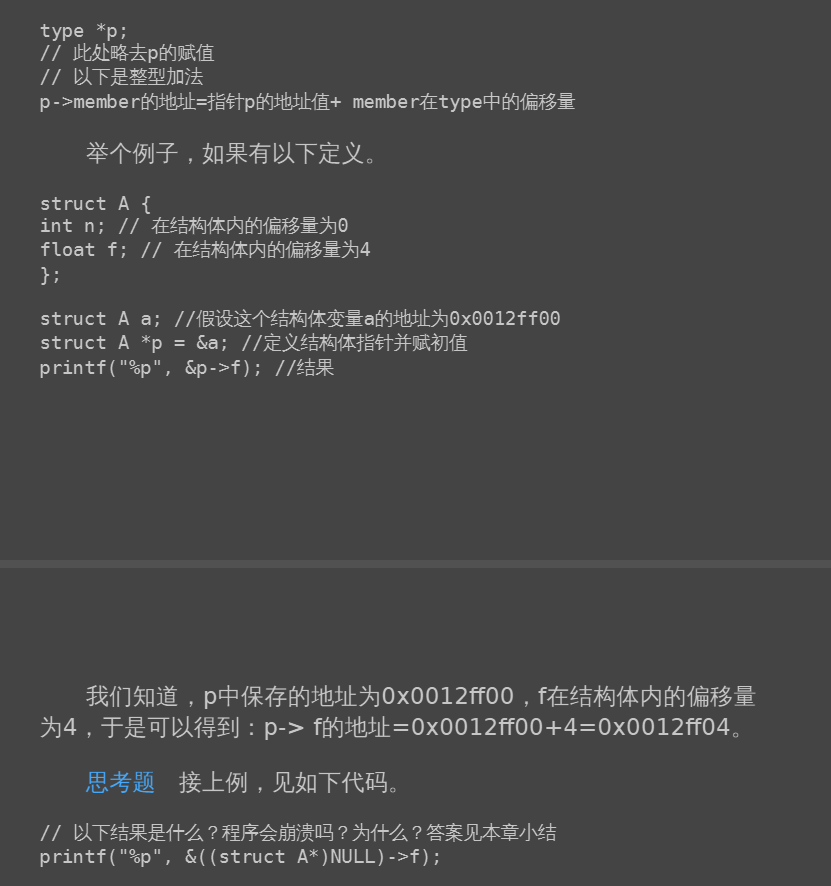
- 根据字面含义,this指针应属于指针类型。this指针在32位环境下占4字节空间,在64位环境下占8字节空间,保存的数据为地址信息。“this”可翻译为“这个”,因此经过字面分析可认为this指针中保存了所属对象的首地址。9.1节介绍了对象的组成和它们在内存中的布局,但是并没有分析如何访问对象中的数据成员。接下来,我们从访问对象的数据成员和成员函数入手,分析this指针的使用过程。先来了解一下使用指针访问结构体或类成员的公式,假设type为某个正确定义的结构体或者类,member是type中可以访问的成员。
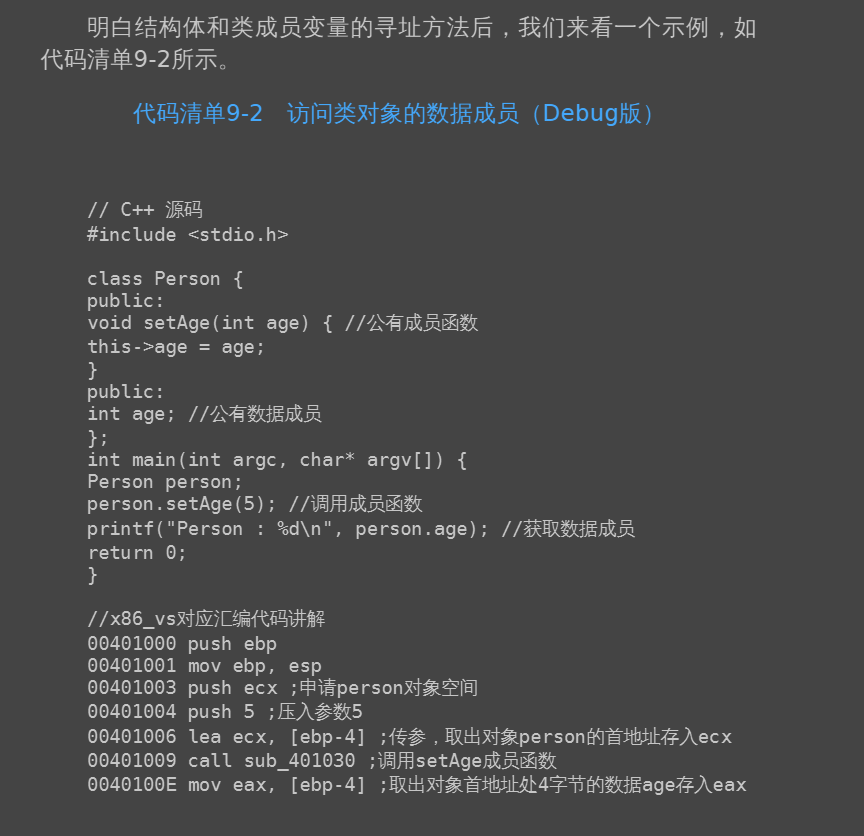
- 代码清单9-2中演示了对象调用成员的方法以及取出数据成员的过程。使用默认的调用约定时,在调用成员函数的过程中,编译器做了一个“小动作”:利用寄存器ecx保存了对象的首地址,并以寄存器传参的方式将其传递到成员函数中,这便是this指针的由来。由此可见,所有成员函数(非静态成员函数)都有一个隐藏参数,即自身类型的指针,这样的默认调用约定称为thiscall。
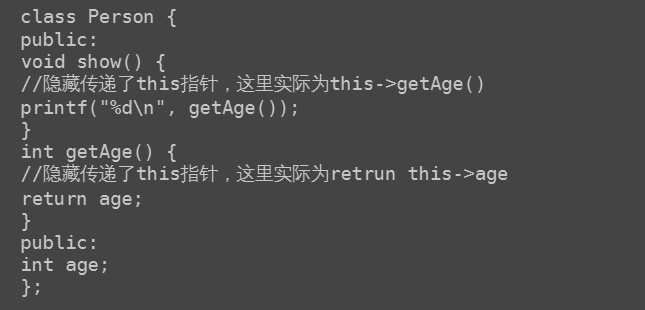
- 在成员函数中访问数据成员也是通过this指针间接访问的,这便是在成员函数内可以直接使用数据成员的原因。在类中使用数据成员和成员函数时,编译器隐藏了如下操作。
- 在C++的环境下,识别this指针的关键点是在函数的调用过程中使用ecx作为第一个参数,在ecx中保存的数据为对象的首地址,但并非 所 有 this 指 针 的 传 递 都 是 如 此 。 在 代 码 清 单 9-2 中 , 成 员 函 数SetAge的调用方式为thiscall。thiscall的栈平衡方式与__stdcall相同,都是被调用方负责平衡。但是,两者传递参数的过程却不一样,声明为thiscall的函数,第一个参数使用寄存器ecx传递,而非通过栈 顶传递。而且thiscall并不属于关键字,它是C++中成员函数特有的调用方式,在C语言中是没有这种调用方式的。由于在C++环境下,thiscall不属于关键字,因此函数无法显式声明为thiscall调用方式,而类的成员函数默认为thiscall调用方式。所以,在分析过程中,如果看到某函数使用ecx传递参数,且ecx中保留了对象的this指针以及在函数实现代码内,存在this指针参与的寄存器相对间接访问方式,如[reg+8],即可怀疑此函数为成员函数。因为64位程序本来就使用rcx传递参数,所以无此特征。
- 当使用其他调用方式(如__stdcall)时,this指针将不再使用ecx传 递 参 数 , 而 是 改 用 栈 传 递 参 数 。 将 代 码 清 单 9-2 中 的 成 员 函 数SetAge()修改为__stdcall调用方式,查看this指针的传递与使用过程,如代码清单9-3所示。
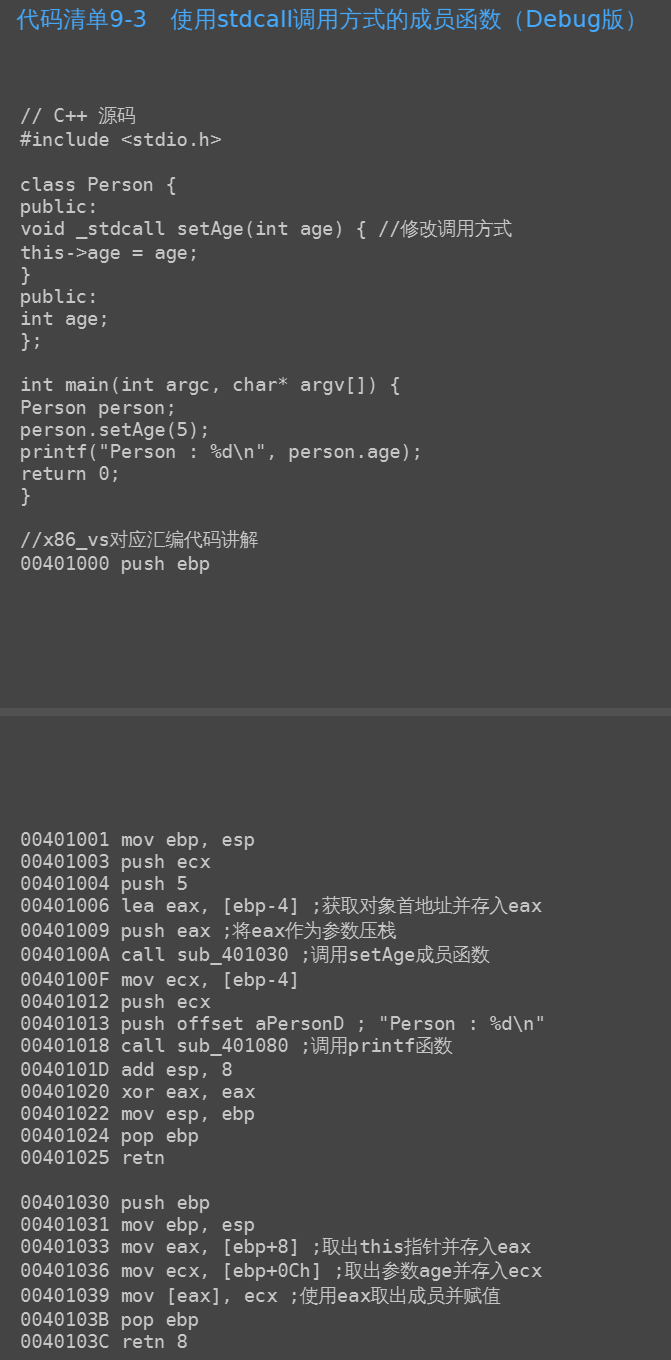
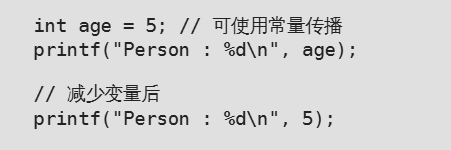
- 在代码清单9-3中,成员函数setAge()在调用过程中没有通过ecx传递this指针,取而代之的是以栈方式传递参数。#cdecl和#stdcall调用方式只是在参数平衡时有所区别,这里就不详细讲解了。使用#cdecl和#stdcall声明的成员函数,this指针并不像thiscall那样容易识别。使用栈方式传递参数,并且第一个参数为对象首地址的函数很多,很难区分。虽然难以区分,但如果能确定函数的第一个参数为this指针,并且在函数体内将this指针存入某寄存器,然后出现寄存器相对间接访问方式,那么将其还原为成员函数也是等价的。在02选项中,代码清单9-2和代码清单9-3经过优化后,类对象不复存在,只是使用printf函数输出数字5。setAge()函数完成的功能是将数据成员age赋值为常量5。其他代码没有再对此变量做任何修改,而类对象person只有一个数据成员age,该对象除了为数据成员赋值外,并无其他操作,因此编译器作了减少变量的优化处理。转换后代码如下所示。
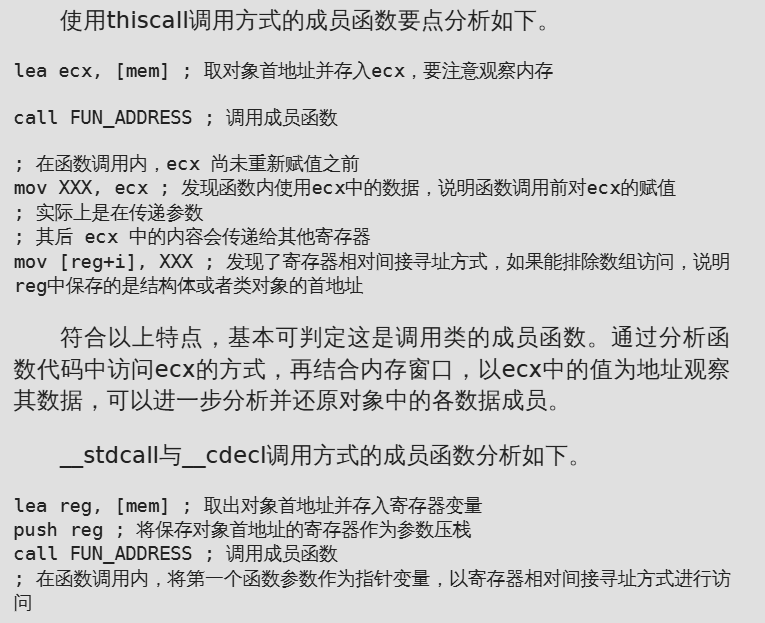
- 对于这种形式的代码,应重点分析压入的第一个参数是否为对象的首地址。如果是,则通过分析可知,该函数等价于此对象中的成员函数。根据第一个参数的使用以及它所指向的地址,可还原该结构中的各数据成员。 对于64位程序,应重点分析rcx是否为对象的首地址。如果是,则通过分析可知,该函数等价于该对象中的成员函数。根据rcx参数的使用以及它所指向的地址,可还原该结构中的各数据成员
静态数据成员
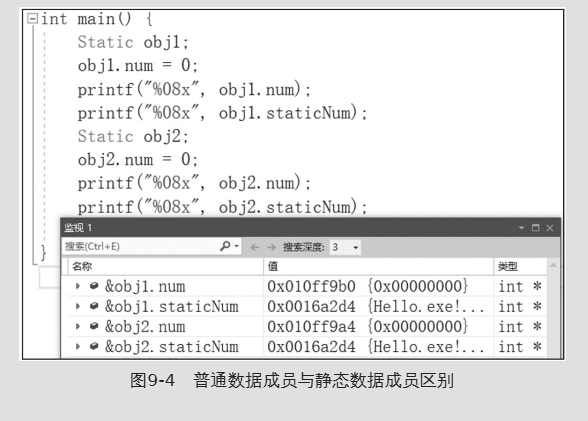
- 当类中定义了静态数据成员时,因为静态数据成员和静态变量原理相同(都是含有作用域的特殊全局变量),所以该静态数据成员的初值会被写入编译链接后的执行文件。当程序被加载时,操作系统将执行文件中的数据读到对应的内存单元里,静态数据成员已经存在,而这时类并没有实例对象。静态数据成员和对象之间的生命周期不同,并且静态数据成员也不属于某一对象,与对象之间是一对多的关系。静态数据成员仅仅和类相关,和对象无关,多个对象可以拥有同一个静态数据成员,如图9-4所示。
- 在图9-4中,定义了两个Static类对象obj1和obj2。Static类的定义如下面的代码所示。根据图9-4中监视器窗口的内容,两个对象各自的数据成员在内存中的地址不同,而静态数据成员的地址却相同。可见,类中的普通数据成员对于同类对象而言是独立存在的,而静态数据成员则是所有同类对象的共用数据,静态数据成员和对象是一对多的关系
- 因为静态数据成员有此特性,所以在计算类和对象的长度时,静态数据成员属于特殊的独立个体,不被计算在其中,代码如下所示。
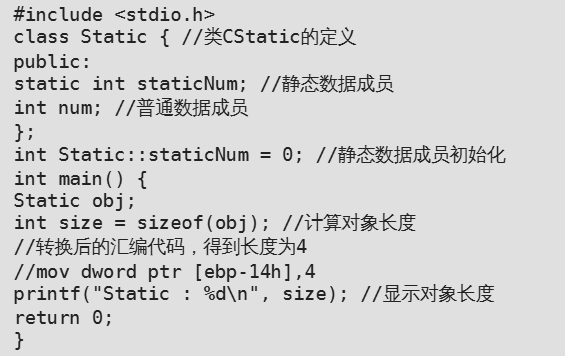
- 通 过 sizeof 获 得 对 象 obj 占 用 的 内 存 长 度 为 4 。 静 态 数 据 成 员staticNum没有参与对象obj的长度计算。staticNum为静态数据成员,num为普通数据成员,两者所属的内存地址空间不同,这也是静态数据成员不参与长度计算的原因之一,两者对比如下。
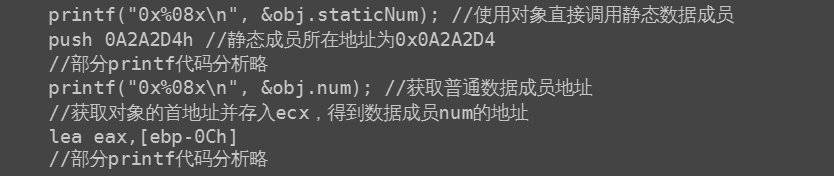
- 在以上代码分析中,静态数据成员所在的地址为0x0A2A2D4,而普通数据成员的地址在ebp-0Ch中,是一个栈空间地址。在使用的过程中,静态数据成员是常量地址,可通过立即数间接寻址的方式访问。普通数据成员只有在类对象产生后才出现,地址值无法确定,只能以寄存器相对间接寻址的方式进行访问。在成员函数中使用这两种数据成员时,因为静态数据成员属于全局变量,并且不属于任何对 象,所以访问时无须this指针。而普通的数据成员属于对象所有,访问时需要使用this指针,如代码清单9-4所示。
- 静态数据成员在反汇编代码中很难被识别,这是因为其展示形态与全局变量相同,很难被还原成对应的高级代码。可参考其代码的功能,酌情处理。
对象作为函数参数
- 对象作为函数的参数时,其传递过程较为复杂,传递方式也比较独特。对象的传参过程与数组不同,数组变量的名称代表数组的首地址,而对象的变量名称却不能代表对象的首地址。传参时不会像数组那样以首地址作为参数传递,而是先将对象中的所有数据进行备份(复制),将备份的数据作为形参传递到调用函数中使用。
- 在基本的数据类型中,32位程序下,除双精度浮点和long long类型外,其他所有数据类型的大小都不超过4字节,64位程序类型不超过8字节,使用一个栈元素即可完成数据的复制和传递。而类对象是自定义数据类型,是除自身外的所有数据类型的集合,各个对象的长度不定。对象在传参的过程中是如何被复制和传递的呢?
- 类Person的体积不大,只有两个数据成员,编译器在调用函数传参的过程中分别将对象的两个成员依次压栈,也就是直接将两个数据成员当成两个int类型数据,并将它们当作printf函数的参数。64位程序中直接使用一个寄存器存储类的两个数据成员。同理,它们也是一份复制数据,除数据相同外,与对象中的两个数据成员没有关系。
- 类对象中数据成员的传参顺序为最先定义的数据成员最后压栈,最后定义的数据成员最先压栈。当类的体积过大,或者其中定义有数组类型的数据成员时,会将数组的首地址作为参数压栈吗?我们来看看代码清单9-6。
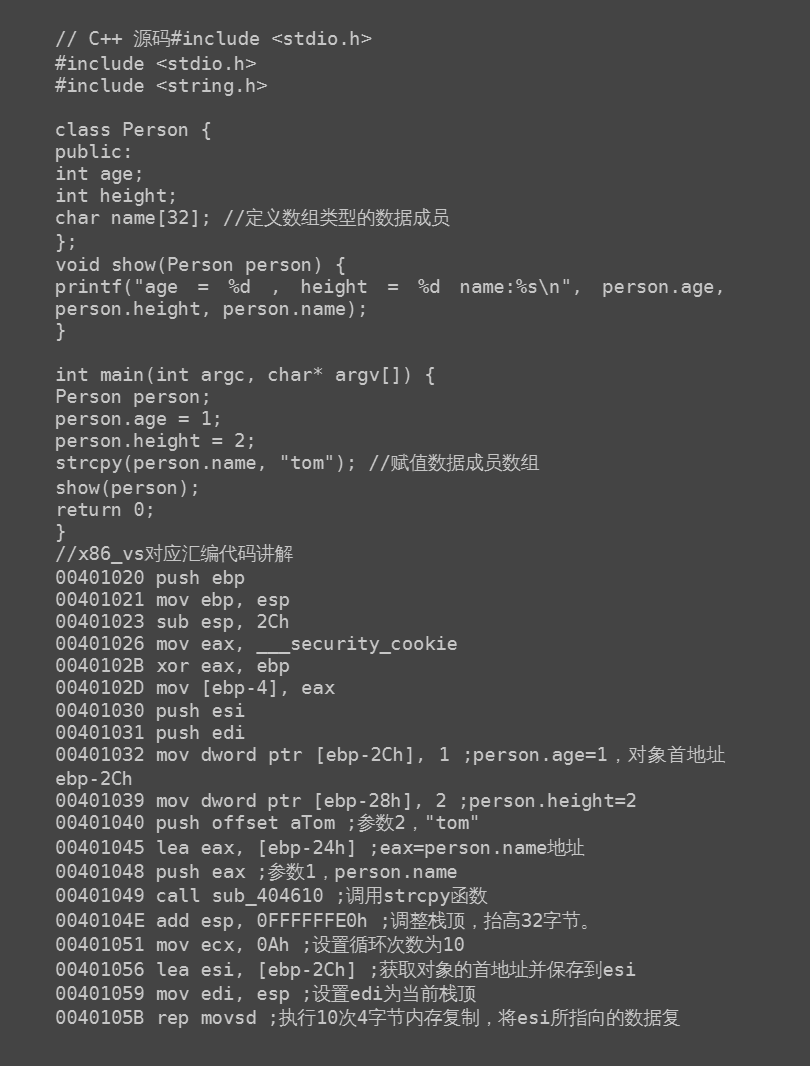
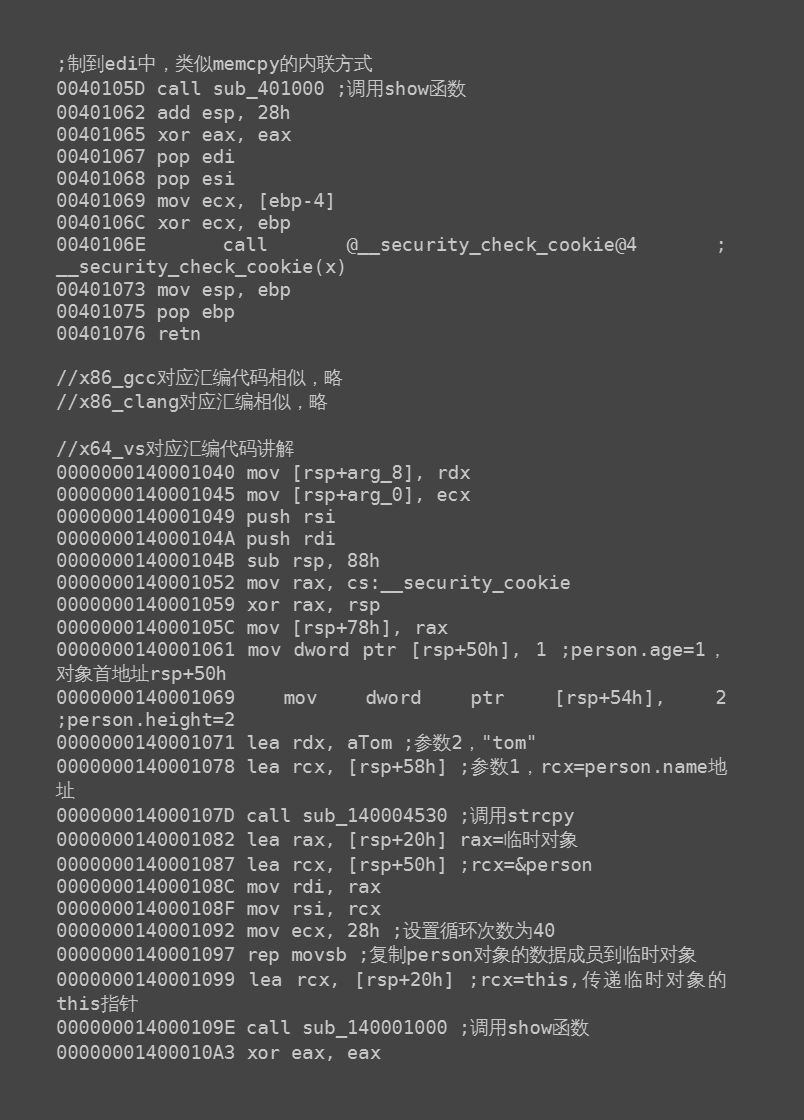
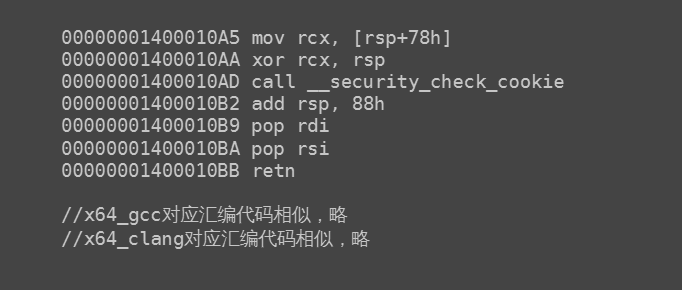
- 如代码清单9-6所示,在传递类对象的过程中使用了“add esp, 0FFFFFFE0h” 调 整 栈 顶 指 针 esp , 0FFFFFFE0h 是 补 码 , 转 换 后为-20h,等同于esp-20h。6.1节介绍过,参数变量在传递时,需要向低地址调整栈顶指针esp,此处申请的32字节栈空间,加上strcpy未平衡的8字节参数空间,都用于存放参数对象person的数据。将对象person中的数据依次复制到申请的栈空间中,对象person的内存布局如图9-5所示。
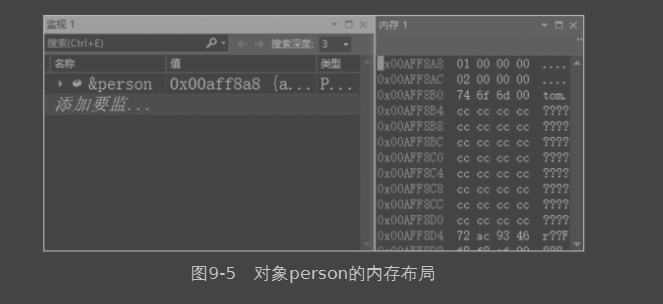
- 在图9-5中,0x00AFF8A8为对象person的首地址,第一个4字节的数据为数据成员age。由此向后,第二个4字节的数据为数据成员height,以0x00AFF8B0为起始地址,后面的第一个32字节数据为数组成员name。对象person占用的内存大小为40字节,而代码清单9-6却只为栈空间申请了32字节。以对象的首地址为起始点,使用指 令“rep movs”复制了40字节的数据,比栈空间申请的大小多出了8字节。为什么申请栈空间时少了8字节呢?数据复制完成后会不会造成越界访问呢?
- 我 们 先 看 一 下 之 前 调 用 的 函 数 strcpy , 该 函 数 的 调 用 方 式 为__cdecl,当函数调用结束后,并没有平衡参数使用的栈顶。函数strcpy有两个参数,正好使用了8字节的栈空间。在函数show的调用过程中,重新利用这8字节的栈空间,完成了对对象person中数据的复制。当函数show调用结束后,调用指令“add esp,28h”平衡了该函数参数使用的40字节栈空间。
- 在64位程序中,因为栈顶为栈预留空间,所以无法将对象的数据成员复制到栈顶,编译器将对象的数据成员先复制到临时对象,再将临时对象的地址传递给show函数,在show函数内部使用this指针间接访问对象的数据成员。
- 代码清单9-4和代码清单9-5中定义的类都没有定义构造函数和析构函数。对象作为参数在传递过程中会制作一份对象的复制数据,当向对象分配内存时,如果有构造函数,编译器会再调用一次构造函数,并做一些初始化工作。当代码执行到作用域结束时,局部对象将被销毁,而对象中可能会涉及资源释放的问题,同样,编译器也会再调用一次局部对象的析构函数,从而完成资源数据的释放。
- 有参考资料中提到,当类中没有定义构造函数和析构函数时,编译器会添加默认的构造函数和析构函数。根据代码清单9-4和代码清单9-5中的分析可知,在定义类对象时,编译器根本没有做任何处理,可见编译器并没有添加默认的构造函数。其原因涉及更多构造函数与析构函数的知识,详见第10章。
- 当对象作为函数的参数时,因为重新复制了对象,所以等同于又定义了一个对象,在某些情况下会调用特殊的构造函数——复制构造函数,详见第10章。当函数退出时,复制的对象作为函数内的局部变 量,将会被销毁。当存在析构函数时,则会调用析构函数,这时问题就会出现了
- 当对象作为参数传递时,参数obj复制了对象person中的数据成员name,产生了两个Person类的对象。由于没有编写复制构造函数,因此在传递参数的时候就没有被调用,这时候编译器以浅拷贝处理,它们的数据成员name都指向了同一个堆地址,如图9-6所示。
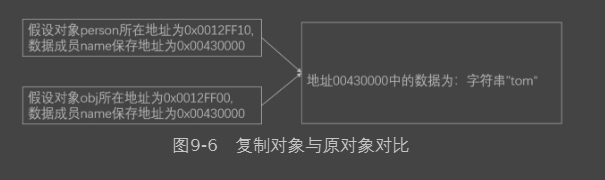
- 两个对象中的数据成员name指向了相同地址,当函数show调用结束后,便会释放对象obj,以对象obj的首地址作为this指针调用析构函数。在析构函数中,调用delete函数释放对象obj的数据成员name保存的堆空间的首地址。但对象obj是person的复制品,真正的person仍存在,而数据成员name保存的堆空间的首地址却被释放了,如果出现以下代码便会产生错误。
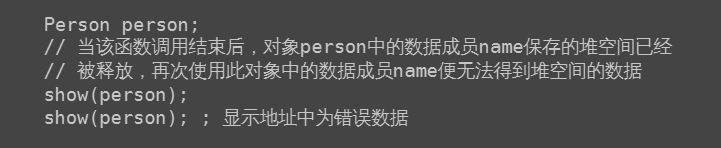
- 这个错误在VS的编译中被触发,因为使用delete函数后,堆空间被置为某个标记值;而在02选项中,并不会对释放堆中的数据进行检查。如果没有再次申请堆空间,此地址中的数据仍然存在,会导致错误被隐蔽,为程序埋下隐患。
- 有两种解决方案可以修正这个错误:深拷贝数据和设置引用计数,这两种解决方案都需要复制构造函数的配合。本节中只做简单的讲解,详见第10章。
深拷贝数据
- 在复制对象时,编译器会调用一次该类的复制构造函数,给编码者一次机会。深拷贝利用这次机会原对象的数据成员保存的资源信息制作一份副本。
- 这样,当销毁复制对象时,销毁的资源是复制对象在复制构造函数中制作的副本,而非原对象中保存的资源信息。
设置引用计数
- 在进入复制构造函数时,记录类对象被复制引用的次数。当对象被销毁时,检查这个引用计数中保存的引用复制次数是否为0。如果是,则释放申请的资源,否则引用计数减1。
- 当参数为对象的指针类型时,则不存在这种错误。传递的数据是指针类型,在函数内的操作都是针对原对象的,不存在对象被复制的问题。因为没有副本,所以在函数进入和退出时不会调用构造函数和析构函数,也就不存在资源释放的错误隐患。在使用类对象作为参数时,如无特殊需求,应尽量使用指针或引用。这样做不但可以避免资源释放的错误隐患,还可以在函数调用过程中避免复制对象的过程,提升程序运行的效率。
- 由于我们目前所学知识还无法修正这个错误,因此暂且将其搁置。虽然错误没有解决,但并不影响后面的学习。学习了构造函数和析构函数的相关知识后,这个问题便会迎刃而解。
对象作为返回值
- 对象作为函数的返回值时,与基本的数据类型不同。基本数据类型(浮点类型、非标准类型除外)作为返回值时,32位程序不超过4字节的数据通过eax返回,在64位程序不超过8字节的数据使用rax返回。而对象属于自定义类型,寄存器eax/rax无法保存对象中的所有数据,所以在函数返回时,寄存器eax/rax不能满足需求。
- 对象作为返回值与对象作为参数的处理方式非常相似。对象作为参数时,进入函数前预先保留对象使用的栈空间并将实参对象中的数据复制到栈空间中。该栈空间作为函数参数,用于函数内部使用。同理,对象作为返回值时,进入函数后将申请返回对象使用的栈空间,在退出函数时,将返回对象中的数据复制到临时的栈空间中,以这个临时栈空间的首地址作为返回值。
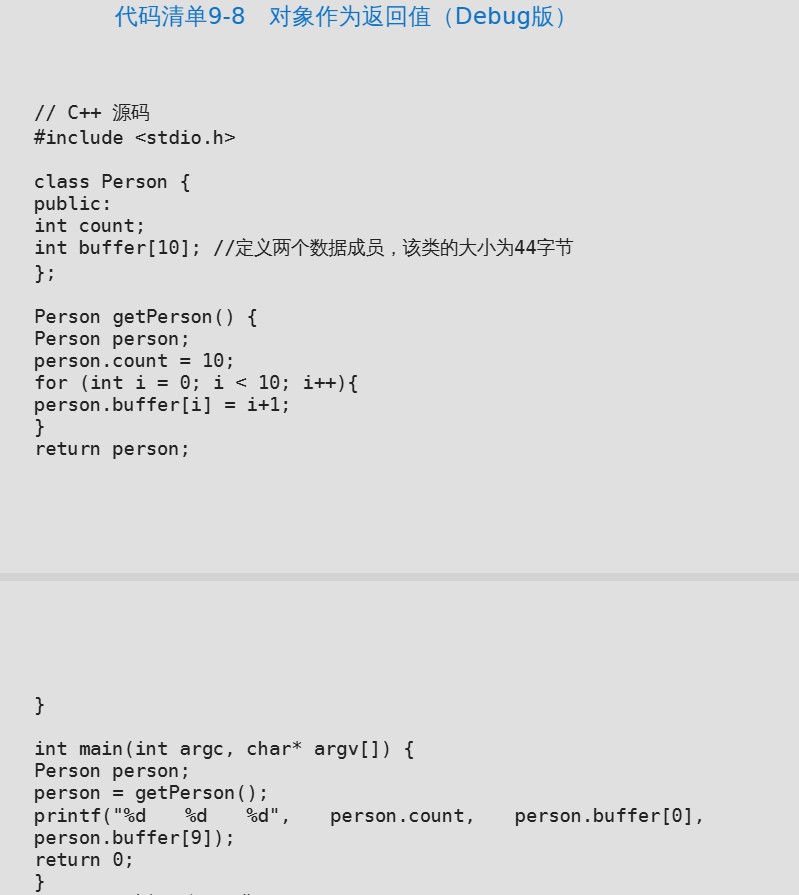
- 在调用getPerson前,编译器将在main()函数中申请的返回对象的首地址作为参数压栈,在函数getPerson调用结束后进行数据复制,将getPerson函数中定义的局部对象person的数据复制到这个返回对象的空间中,再将这个返回的对象复制给目标对象person,从而达到返回对象的目的。因为在这个示例中不存在函数返回后为对象的引用赋值,所以这里的返回对象是临时存在的,也就是C++中的临时对象,作用域仅限于单条语句。
- 为什么会产生这个临时对象呢?因为调用返回对象的函数时,C++程序员可能采用这类写法,如getPerson().count,这只是针对返回对象的操作,而此时函数已经退出,其栈帧也被关闭了。函数退出后去操作局部对象显然不合适,因此只能由函数的调用方准备空间,建立临时对象,然后将函数中的局部对象复制给临时对象,再把这个临时对象交给调用方去操作。本例中的person = getPerson();是个赋值运算,因为赋值时getPerson函数已经退出,所以栈空间也关闭了。同理,person不能直接和函数内局部对象做赋值运算,因此需要临时对象记录返回值之后再参与赋值。
- 虽然使用临时对象进行了数据复制,但是同样存在出错的风险。这与对象作为参数时遇到的情况一样,因为使用了临时对象进行数据复制,所以当临时对象被销毁时,会执行析构函数。如果析构函数中有对资源释放的处理,就有可能产生同一个资源多次释放的错误。 这个错误与对象作为函数参数时的错误在原理上是一样的,也是临时对象被析构造成的,因此两者的解决方案也相同。对于复制对象的资源释放错误,我们会在第10章分析错误的处理过程并给出详细的解决方案。
- 当对象作为函数的参数时,可以传递指针;当对象作为返回值时,如果对象在函数内部被定义为局部变量,则不可返回此对象的首地址或引用,以避免返回已经被释放的局部变量,代码如下所示。
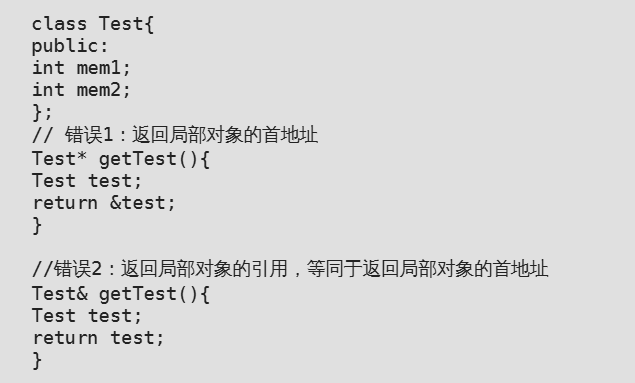
- 由于函数退出后栈内对象的空间将被释放,因此无法保证返回值指向地址的数据的正确性。引用返回值后,如果运气好,会导致数据访问错误和程序当场出错。如果运气再好一点,程序就会直接崩溃,这样就能在调试的时候发现错误。如果运气实在很差,在开发时数据访问正常,程序也工作正常,这个问题可能会成为一个隐藏很深的错误。不过不用太担心,只要你在VS工程中设置的警告级别(warning level)不是None,这个问题在编译检查时就会被警告,只要你不漠视编译器的每个警告就行,最好把Warnings as errors打上勾。要解决此类错误,只能避免返回函数内局部变量的地址,但可以返回堆地址,还可以使用返回对象的办法来代替。由此可见,使用返回值为类对象的情况具有特殊的意义。 编译器在处理简单的结构体和类结构时,二者经过02选项的编译优化后,将难以区分它们和局部变量,但仍可根据数据的访问过程还原相应的数据
关于本文
由 GuQing 撰写,采用 CC BY-NC 4.0 许可协议。